Metodologi pengolahan data mentah menjadi wawasan prediktif dan deskriptif yang dapat dipertanggungjawabkan.
👋 Selamat Datang di Portofolio Analitika Data
Andrey Satrio Pramono
Calon Analis Data Sektor Publik & Praktisi Akuntansi
Saya adalah mahasiswa Program Studi Akuntansi Sektor Publik di Politeknik Keuangan Negara STAN (IPK: 3,84) dengan keahlian dalam analisis data keuangan sektor publik, pemodelan prediktif, komunikasi profesional, dan kerja sama tim. Kemampuan tersebut telah saya asah melalui berbagai pengalaman kepanitiaan, kepemimpinan teater kampus (Produser di Teater Alir PKN STAN), serta penyelesaian proyek analitika data komprehensif mencakup klasifikasi risiko keuangan publik multi-algoritma dan klastering kinerja menggunakan Orange Data Mining, Microsoft Excel tingkat lanjut, dan Python. Dikenal sebagai individu yang empatik, adaptif, serta berorientasi pada solusi dan hasil yang terukur guna memberikan kontribusi nyata di lingkungan kerja yang dinamis.
Kompetensi & Sertifikasi
Keahlian & Penguasaan Perkakas
Kombinasi kompetensi analitika data kuantitatif, pemodelan prediktif machine learning, serta rekam jejak kepemimpinan kegiatan.
Perangkat lunak analitika, pemodelan spreadsheet, dan generative AI yang terintegrasi.
Pelatihan resmi yang diikuti serta rekam jejak kepanitiaan dan kepemimpinan organisasi.
Studi Kasus Analitika Unggulan
Analisis Komprehensif Risiko & Kinerja Sektor Publik
Penerapan *Supervised Machine Learning* (Klasifikasi Multi-Model) dan *Unsupervised Learning* (Klastering K-Means) pada 500 organisasi sektor publik.
Proyek Analitika Komprehensif (End-to-End)
UTS ADKSP • Semester 6 (2026)
Klasifikasi Tingkat Risiko Keuangan Publik Multi-Algoritma & Segmentasi Klastering Kinerja
Model Terbaik
SVM
Support Vector Machine
Akurasi Klasifikasi (CA)
71,8%
Tertinggi di antara 6 model
Presisi & Recall
64,3% / 71,8%
F1-Score: 0,618 | MCC: 0,146
Klastering K-Means
k = 3
Pemisahan klaster sangat tajam
1
Data Understanding, Deteksi Anomali & Preprocessing
Karakteristik Dataset: Terdiri dari 500 baris observasi dan 10 kolom fitur (4 kategorikal: tipe_organisasi, wilayah, status_blud, kategori_ukuran; 1 target: status_risiko dengan 3 kelas; 3 numerik: jumlah_pegawai, pendapatan, belanja; serta 2 metadata: kode_organisasi dan tanggal_pembentukan).
Identifikasi Anomali Data:
- Missing Value: Ditemukan 105 nilai kosong (3%) pada fitur dan 46 (4,6%) pada kolom meta.
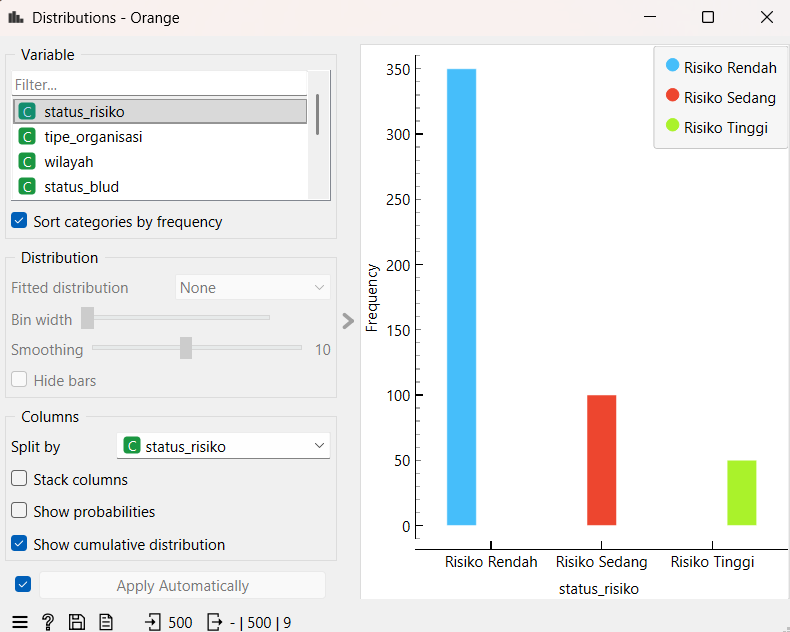
- Class Imbalance: Distribusi data didominasi oleh kelas Risiko Rendah, disusul Risiko Sedang dan Risiko Tinggi.
- Outlier: Terdeteksi sebaran titik ekstrem di luar batas normal pada variabel numerik (terutama
jumlah_pegawaidanbelanja).
Strategi Preprocessing: Dilakukan feature normalization ke interval konsisten agar atribut dengan skala besar (seperti nilai belanja miliaran) tidak mendistorsi bobot algoritma klasifikasi.
2
Pembangunan Multi-Model & Evaluasi Test and Score
Enam arsitektur algoritma machine learning diuji secara simultan menggunakan metode 10-Fold Stratified Cross-Validation guna mengukur kestabilan dan daya generalisasi model terhadap data baru:
| Model Algoritma | Akurasi (CA) | F1-Score | Precision | Recall | MCC | AUC |
|---|---|---|---|---|---|---|
| ⭐ SVM (Support Vector Machine) | 0.718 (71,8%) | 0.618 | 0.643 (64,3%) | 0.718 (71,8%) | 0.146 | 0.543 |
| Logistic Regression | 0.709 | 0.596 | 0.599 | 0.709 | 0.052 | 0.523 |
| Random Forest | 0.696 | 0.617 | 0.588 | 0.696 | 0.092 | 0.521 |
| kNN (k-Nearest Neighbors) | 0.696 | 0.614 | 0.622 | 0.696 | 0.102 | 0.569 |
| Naive Bayes | 0.676 | 0.609 | 0.574 | 0.676 | 0.075 | 0.528 |
| Decision Tree | 0.556 | 0.565 | 0.560 | 0.556 | 0.038 | 0.522 |
Justifikasi Pemilihan SVM: SVM terpilih sebagai model terbaik secara keseluruhan karena mengungguli seluruh model lain pada kombinasi metrik utama: Akurasi tertinggi (71,8%), Presisi tertinggi (64,3%), Recall tertinggi (71,8%), F1-Score tinggi (0,618), serta koefisien korelasi Matthews (MCC: 0,146) paling positif.
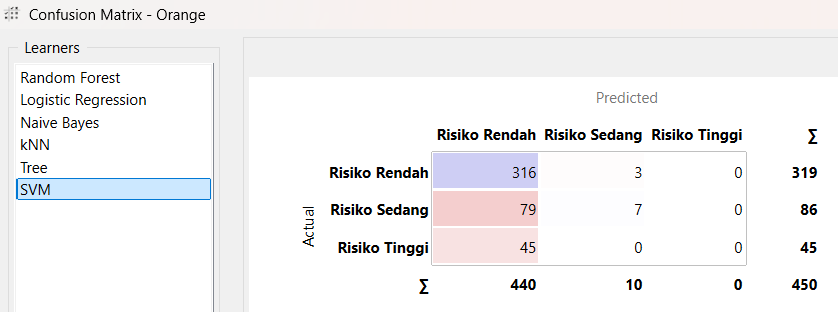
Evaluasi Confusion Matrix: Model SVM mampu memprediksi 316 dari 319 entitas Risiko Rendah secara akurat. Kendala klasifikasi pada risiko sedang dan tinggi dipengaruhi oleh ketidakseimbangan kelas (*class imbalance*) alami pada data publik.
3
Segmentasi Kinerja K-Means ($k=3$) & Visualisasi Scatter Plot
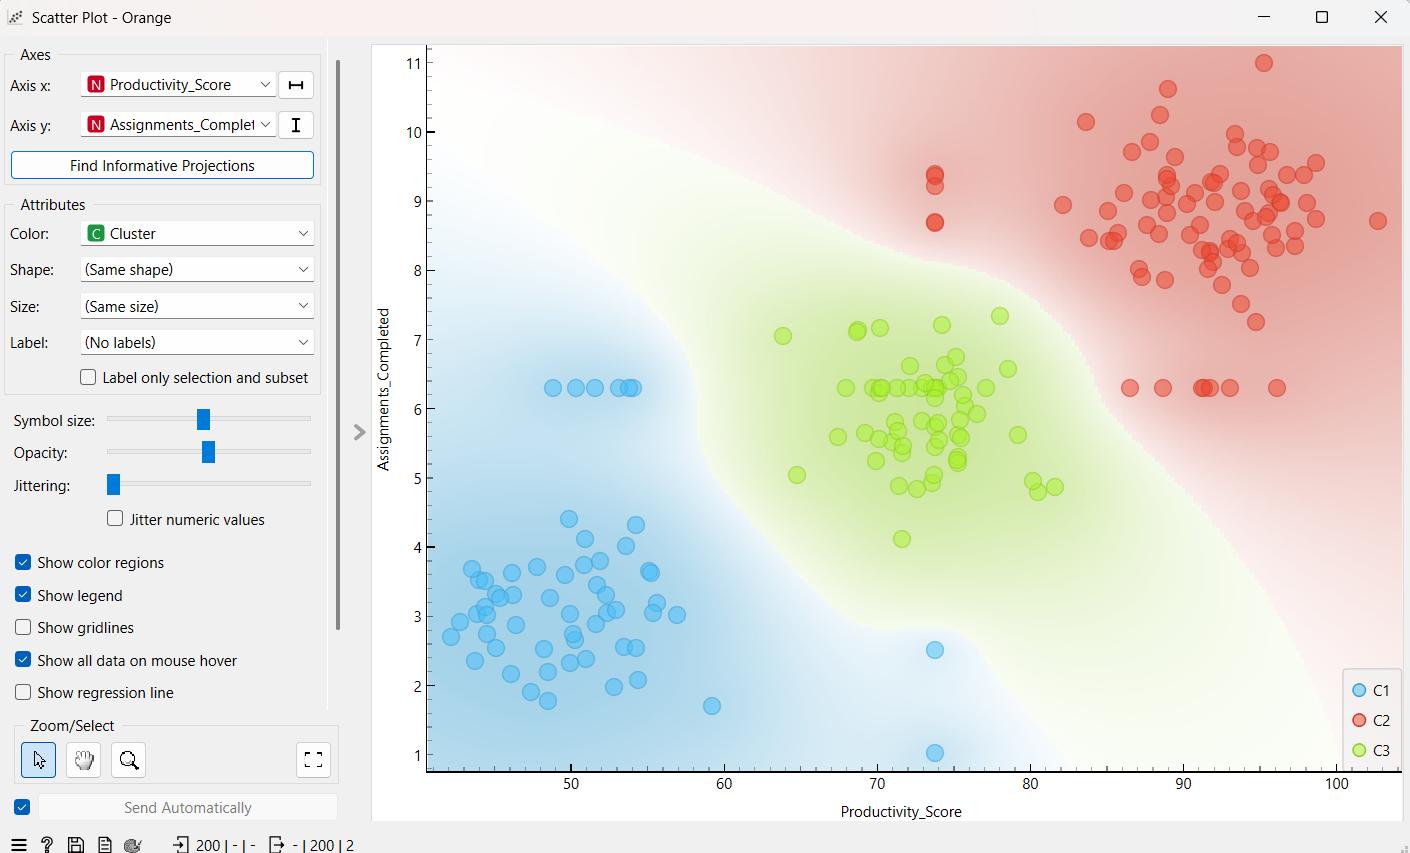
Analisis Klastering Unsupervised: Dilakukan pengelompokan entitas berdasarkan indikator kinerja (Productivity Score vs Assignments Completed) tanpa menggunakan label acuan.
Hasil Optimal K-Means ($k=3$):
- Membentuk 3 klaster yang terpisah secara tegas (C1, C2, C3) dengan tingkat pemisahan data yang sangat rapat di dalam kelompok (*high intra-cluster cohesion*).
- Sangat sedikit amatan yang tumpang-tindih (*cross-cluster overlap*), membuktikan kapabilitas diskriminasi K-Means yang prima.
- Memungkinkan pemetaan tipologi produktivitas organisasi sektor publik untuk pengalokasian beban kerja dan insentif.
4
Insight Kebijakan Publik & Rekomendasi Pengawasan
Berdasarkan pemodelan data mining yang dilakukan, dirumuskan 3 rekomendasi strategis bagi instansi pengawas keuangan sektor publik:
1. Pemanfaatan Model SVM untuk Early Warning System Fiskal: Instansi pemerintah dan aparat pengawasan intern (APIP/BAK) dapat mengadopsi model SVM untuk memprediksi probabilitas risiko inefisiensi organisasi secara dini agar audit dan monitoring belanja dilakukan lebih cepat, konsisten, dan berbasis data.
2. Evaluasi Terfokus pada Risiko Sedang & Tinggi: Meskipun mayoritas organisasi berstatus risiko rendah, entitas dengan risiko sedang dan tinggi memerlukan intervensi evaluasi mendalam terhadap tata kelola kas dan perencanaan pengadaan.
3. Diferensiasi Kebijakan Berbasis Tipe Organisasi & Wilayah: Hasil *feature ranking* membuktikan bahwa
tipe_organisasi dan wilayah adalah variabel paling berpengaruh. Kebijakan pengawasan anggaran tidak boleh diseragamkan (*one size fits all*), melainkan harus mempertimbangkan karakteristik operasional dan tantangan geografis masing-masing daerah.
5
Arsitektur Workflow Orange Data Mining & Refleksi Teknis
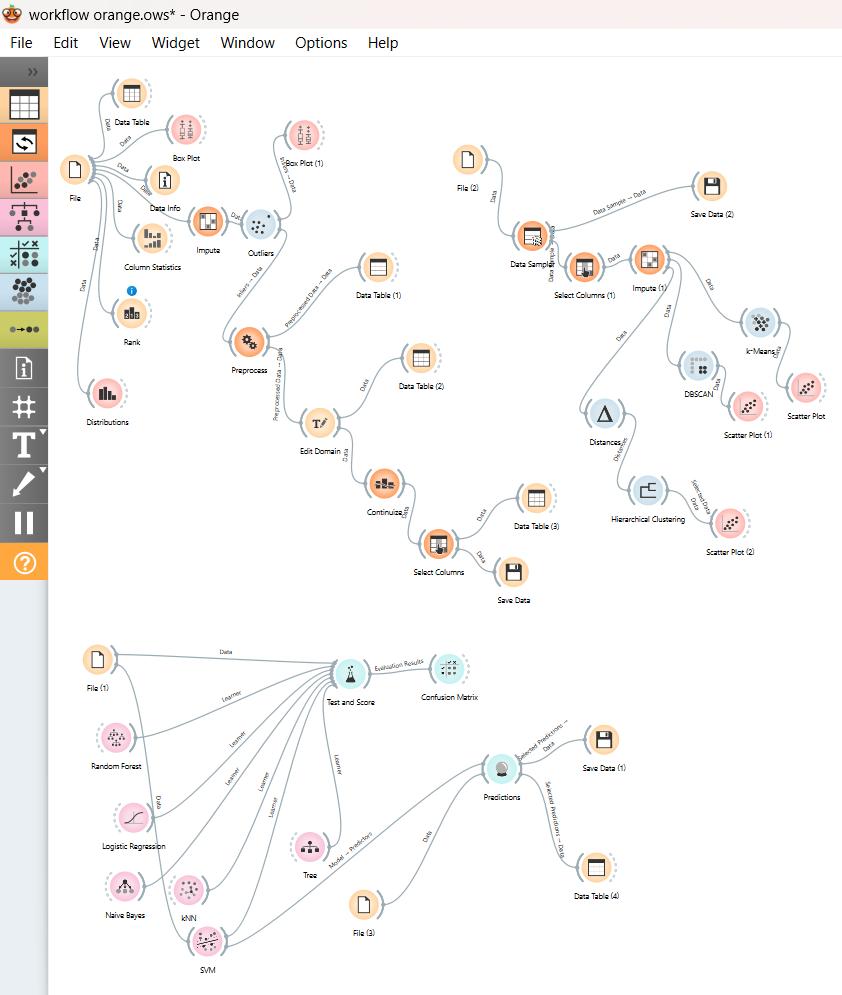
Alur Workflow Terintegrasi: Seluruh tahapan mulai dari pembacaan dataset, inspeksi missing value & outlier, normalisasi fitur, 6 model klasifikasi cross-validation, confusion matrix, prediksi 30 data uji, hingga klastering K-Means dibangun dalam satu kanvas workflow otomatis yang dapat direproduksi (*reproducible*).
Refleksi & Koreksi Model:
Pada iterasi awal, Decision Tree sempat dipilih sebelum dilakukan perbandingan berimbang seluruh metrik. Setelah menganalisis metrik secara komprehensif (Akurasi 71,8% vs 55,6% Tree; Precision 64,3% vs 56,0%), model SVM terbukti jauh lebih unggul dan stabil. Pembelajaran penting ini memperkuat prinsip bahwa evaluasi model data science harus didasarkan pada multi-metrik yang holistik.
Curriculum Vitae Profesional
Unduh dokumen CV resmi format PDF memuat riwayat studi D4 Akuntansi Sektor Publik di PKN STAN (IPK 3,84), pelatihan tersertifikasi, dan rekam jejak kepanitiaan serta kegiatan teater kampus.
🎓 PKN STAN (IPK 3,84)
🏆 Lulusan SMAN 3 Yogyakarta
🎭 Produser Teater Alir PKN STAN
📊 Penguasaan Orange & MS Excel Advanced
Komunikasi
Kanal Kontak
Terbuka untuk kolaborasi riset analitika data sektor publik, diskusi profesional, dan peluang karir di bidang keuangan negara.
Refleksi Pembelajaran
Catatan Penutup & Refleksi ADKSP
Refleksi Praktik Pembuatan Portofolio Berbasis AI
Proses pembangunan portofolio ini merefleksikan sinergi antara peran agen kecerdasan buatan (AI) dan pengambilan keputusan independen oleh mahasiswa. Agen AI membantu menyusun struktur kode semantik, tata letak antarmuka yang responsif, serta memastikan ketaatan terhadap standar aksesibilitas web. Sementara itu, saya secara mandiri memutuskan kurasi substansi materi, memastikan kebenaran seluruh metrik kuantitatif proyek ADKSP (seperti akurasi SVM 71,8%, precision 64,3%, F1-Score 0,618, dan klastering K-Means k=3), menguji interaktivitas laman, serta menentukan arah narasi analitika data. Ke depan, portofolio ini akan terus diperbarui secara berkala seiring bertambahnya proyek riset fiskal dan eksplorasi analitika data sektor publik yang saya selesaikan.